运控算法团队完成了 BK-1 强化学习步态策略的新一轮迭代。
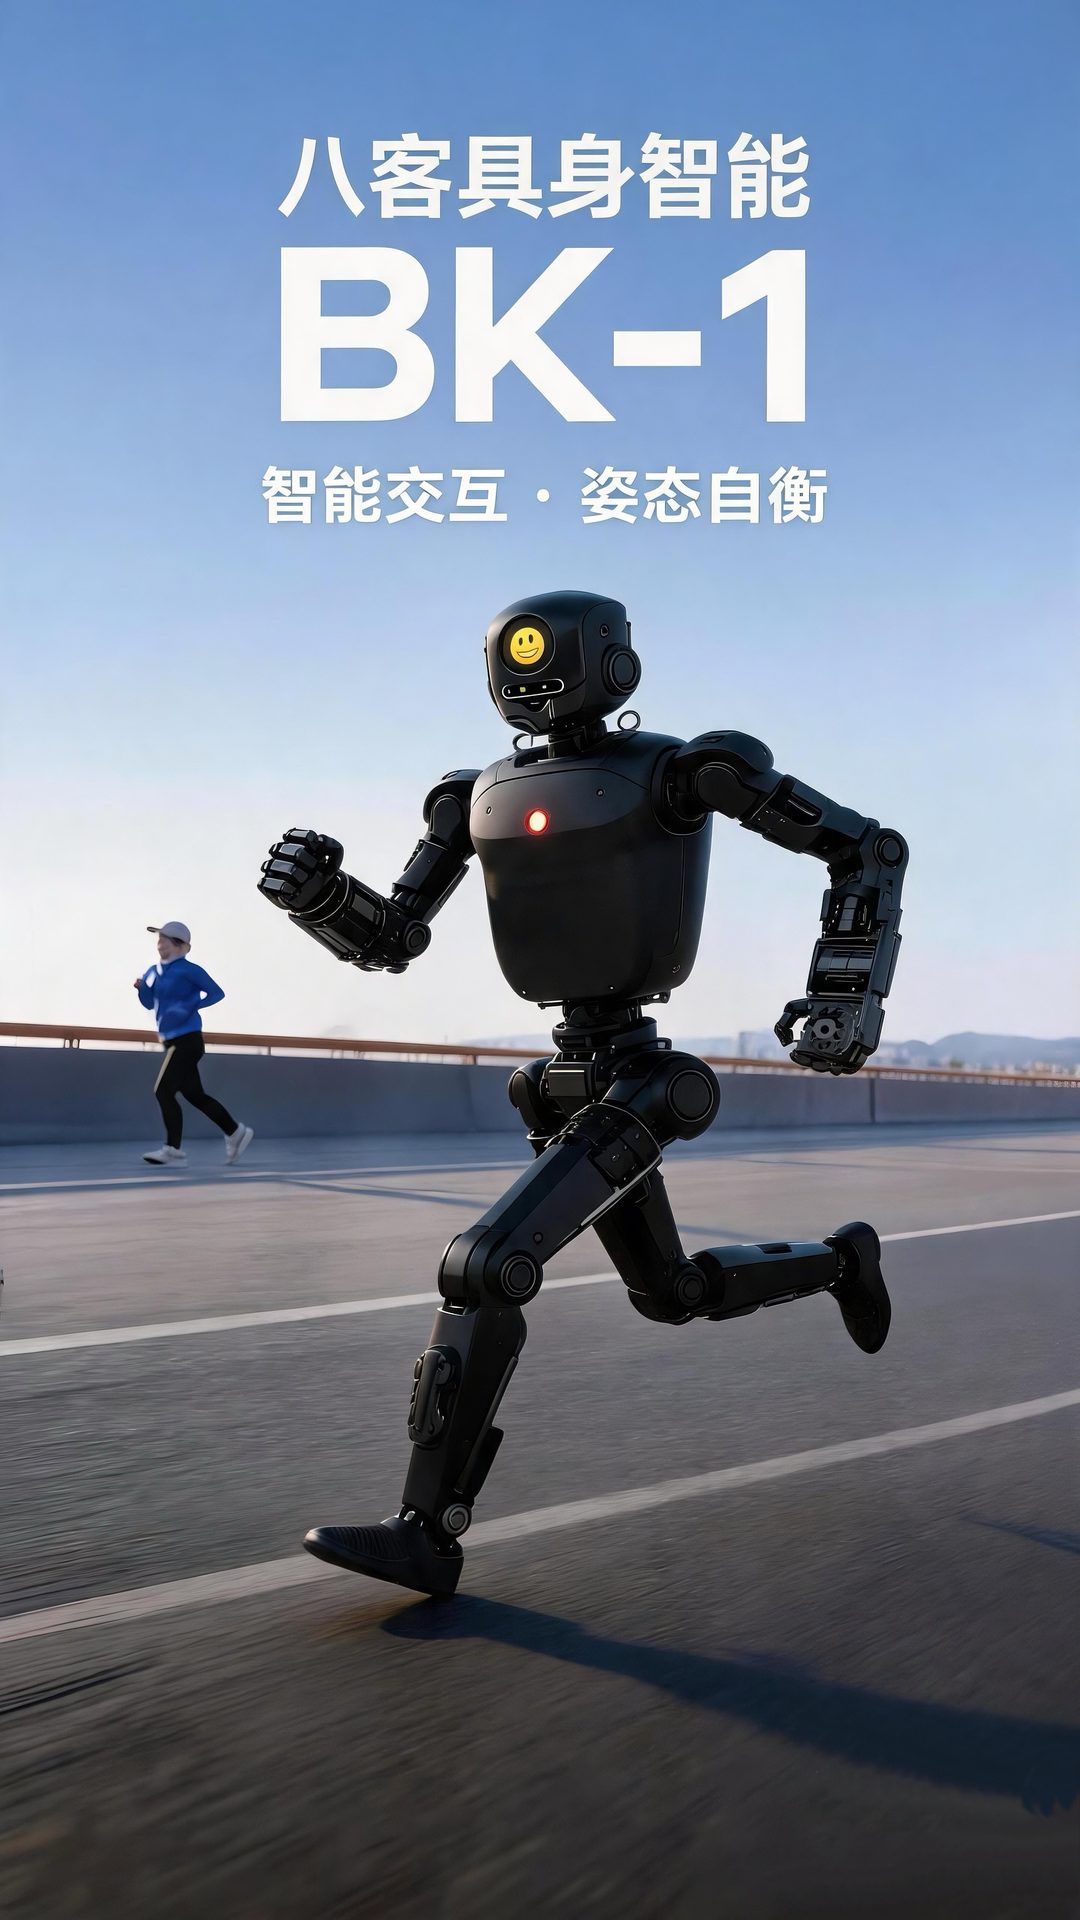
新版本策略在平地行走、变速与快速移动场景下的抗扰动能力显著提升,最大移动速度测试表现符合工程预期。用团队的话说:被推一把之后稳住的时间变短了,高速下的步态也更收敛。
「稳」与「快」是一对天然矛盾。人形机器人靠两条腿支撑,行走本身就是持续的动态平衡;速度越高,留给控制器纠偏的时间窗口就越短——1000Hz 的控制回路,在 5m/s 的移动速度下,每一步的调整机会只有几十毫秒。这一轮迭代的重点,正是把两者的边界往上推:在更高速度下保持步态收敛,同时不牺牲低速行走时的柔顺表现。
迭代方式同样值得一说。BK-1 的运控采用「仿真训练 + 真机微调」双轨流程:先在 MuJoCo 中批量训练策略,让算法在虚拟环境里经历成千上万次试错;再回到真机上用少量样本校正,补上仿真与现实之间的差距——地面的摩擦、关节的间隙、电机的响应延迟,这些细节只有在实机上才能校准。选择 MuJoCo 而不是自建仿真环境,是因为它的动力学精度与社区生态足够成熟,可以把研发资源集中在策略本身。
更重要的是,这套流程让算法的进化不必绑定硬件版本。BK-1 预装平地行走与奔跑的运动控制算法,运动能力的每一次提升,都是通过软件升级完成的——今天交付的机器人,明天可以走得更稳。目前 BK-1 已支持平地行走、变速与快速移动三类场景下的稳定运行,这一轮迭代主要围绕抗扰动能力展开:在受到外力推搡、地面轻微起伏或突然变速时,机器人能够更快恢复平衡,而不是依靠预设动作硬扛。
下一阶段的训练重点已经明确:复杂地形(坡面、台阶、非结构化地面)与负载场景(携带物品、负重行走)。这两类场景对步态策略的要求更高——地形变化要求实时感知与快速调整,负载则改变了机器人的重心分布,需要策略具备更强的泛化能力。相关训练已在 MuJoCo 环境中展开。
运动能力是人形机器人一切应用的基础。团队下一步将把训练扩展到复杂地形与负载场景,让机器人在更多真实环境里保持稳定表现。